0x00 前言 最近遇到花指令的so文件,在此记录一下分析过程。
0x01 dumpSo 这次尝试先分析ARM架构的so文件,毕竟arm的指令简单一点,所以首先要将app以armeabi-v7a架构给安装到手机上使用指令adb install --abi armeabi-v7a xxx.apk来安装APP,在手机上运行的就是arm指令集的app了。并且这样dump下来的so文件也是arm指令集的。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
function my_hook_dlopen (soName ) { Interceptor .attach (Module .findExportByName (null , "android_dlopen_ext" ), { onEnter : function (args ) { var pathptr = args[0 ]; if (pathptr !== undefined && pathptr != null ) { var path = ptr (pathptr).readCString (); if (path.indexOf (soName) >= 0 ) { this .is_can_hook = true ; } } }, onLeave : function (retval ) { if (this .is_can_hook ) { dump_so (soName); } } } ); } function dump_so (so_name ) { var libso = Process .getModuleByName (so_name); console .log ("[name]:" , libso.name ); console .log ("[base]:" , libso.base ); console .log ("[size]:" , ptr (libso.size )); console .log ("[path]:" , libso.path ); var file_path = "/data/data/com.xxxx/files/" + libso.name + "_" + libso.base + "_" + ptr (libso.size ) + "android_dlopen_ext.so" ; var file_handle = new File (file_path, "wb" ); if (file_handle && file_handle != null ) { Memory .protect (ptr (libso.base ), libso.size , 'rwx' ); var libso_buffer = ptr (libso.base ).readByteArray (libso.size ); file_handle.write (libso_buffer); file_handle.flush (); file_handle.close (); console .log ("[dump]:" , file_path); } } setImmediate (my_hook_dlopen ("libxxxx.so" ));
之后进行对应的so文件的基地址修复就好了。
0x02 花指令 这次分析的是一个加密函数,偏移地址是0xb459,反编译出来的伪代码内容如下。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
jbyteArray __fastcall sub_B458 (JNIEnv *a1, int a2, void *a3) { int v5; jbyte *v6; jbyte *v7; void *v8; jbyteArray v9; _DWORD v11[8 ]; v11[1 ] = *(_DWORD *)_stack_chk_guard_ptr; if ( dword_245A8 != 1 ) return (*a1)->NewByteArray(a1, 0 ); v11[0 ] = 0 ; v5 = (*a1)->GetArrayLength(a1, a3); v6 = (*a1)->GetByteArrayElements(a1, a3, 0 ); v7 = v6; if ( v5 < 1 ) return (*a1)->NewByteArray(a1, 0 ); if ( !v6 ) return (*a1)->NewByteArray(a1, 0 ); v8 = malloc (v5 + 36 ); memset (v8, 0 , v5 + 36 ); sub_11BE8(v7, v5, v8, v11); v9 = (*a1)->NewByteArray(a1, v11[0 ]); (*a1)->SetByteArrayRegion(a1, v9, 0 , v11[0 ], (const jbyte *)v8); (*a1)->ReleaseByteArrayElements(a1, a3, v7, 0 ); free (v8); if ( dword_245A8 != 1 ) return (*a1)->NewByteArray(a1, 0 ); return v9; }
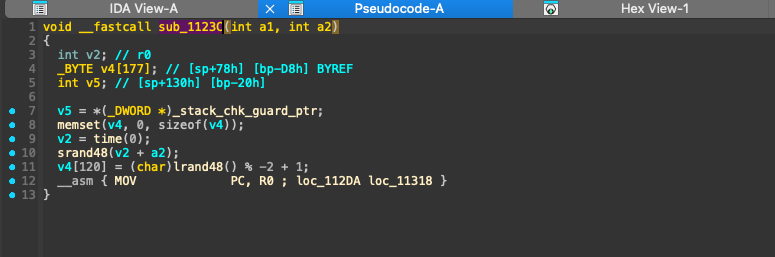
之后跟进到sub_11BE8函数中其实就是单纯的调用了sub_1123C,继续跟进可以看到,存在花指令了。
那么我们可以先使用frida来hook一下sub_11BE8函数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
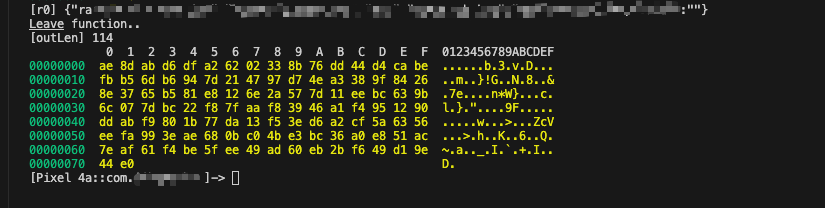
function hook_sub_1123C ( var soname = "libxxx.so" ; var base = Process .getModuleByName (soname).base ; var offset = 0x1123c ; var target = base.add (offset).add (1 ) Interceptor .attach (target,{ onEnter :function (args ){ this .inBuf = args[0 ]; this .inLen = args[1 ]; this .outBuf = args[2 ]; this .outLenPtr = args[3 ]; console .log ('[r0]' , Memory .readUtf8String (this .inBuf , this .inLen .toInt32 ())); }, onLeave :function (retval ){ console .log ("Leave function.." ) const len = Memory .readU32 (this .outLenPtr ); const buf = Memory .readByteArray (this .outBuf , len); console .log ('[outLen]' , len); console .log (hexdump (buf, { offset : 0 , length : len, ansi : true })); } }) }
很明显r0的内容是用户输入参数,r2对应的地址是密文地址。在0xB4C0这个BL调用之前,可以看到会保存现场,将R0,R1,R2,R3都存储好,就进入sub_11BE8函数。
1
2
3
4
5
.text&ARM.extab:0000B4B8 02 AB ADD R3, SP, #8 ; 指向栈上 outLen 的位置,例如 v11[0] .text&ARM.extab:0000B4BA 40 46 MOV R0, R8 .text&ARM.extab:0000B4BC 31 46 MOV R1, R6 .text&ARM.extab:0000B4BE 4A 46 MOV R2, R9 .text&ARM.extab:0000B4C0 06 F0 92 FB BL sub_11BE8
看到sub_1123C对应的汇编中,通过将R0寄存器的内容给PC寄存器来实现跳转,但是这样IDA又无法成功的反编译,不过IDA还是识别到两个跳转地址分别是loc_112DA和loc_11318。如果前边的CMP条件成立就跳转到loc_11318,反之是另外一个。
首先来介绍一下特殊的寄存器
寄存器
功能
R13
SP寄存器,栈指针寄存器
R14
LR寄存器,返回值寄存器
R15
PC寄存器,指向当前程序运行的位置,但是由于ARM三级流水线设计,所以不一定是当前运行的位置,也可以可能是当前运行地址+8的位置。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
.text &ARM .extab:000112 DE loc_112DE .text &ARM .extab:000112 DE 00 20 MOVS R0 , #0 .text &ARM .extab:000112 E0 F4 F7 40 EE BLX time.text &ARM .extab:000112 E4 20 44 ADD R0 , R4 .text &ARM .extab:000112 E6 F4 F7 4 A EE BLX srand48.text &ARM .extab:000112 EA F4 F7 4 E EE BLX lrand48.text &ARM .extab:000112 EE 59 FB 00 01 SMMLA.W R1 , R9 , R0 , R0 .text &ARM .extab:000112 F2 14 2 D CMP R5 , #0x14 .text &ARM .extab:000112 F4 4 F EA D1 12 MOV.W R2 , R1 ,LSR#7 .text &ARM .extab:000112 F8 02 EB D1 71 ADD.W R1 , R2 , R1 ,LSR#31 .text &ARM .extab:000112 FC C1 EB C1 11 RSB.W R1 , R1 , R1 ,LSL#7 .text &ARM .extab:00011300 A0 EB 41 00 SUB.W R0 , R0 , R1 ,LSL#1 .text &ARM .extab:00011304 3 C A9 ADD R1 , SP , #0xF0 .text &ARM .extab:00011306 00 F1 01 00 ADD.W R0 , R0 , #1 .text &ARM .extab:0001130 A 48 55 STRB R0 , [R1 ,R5 ] .text &ARM .extab:0001130 C 30 46 MOV R0 , R6 .text &ARM .extab:0001130 E 18 BF IT NE .text &ARM .extab:00011310 34 30 ADDNE R0 , #0x34 .text &ARM .extab:00011312 00 68 LDR R0 , [R0 ].text &ARM .extab:00011314 40 44 ADD R0 , R8 .text &ARM .extab:00011316 87 46 MOV PC , R0
那么根据分析,不同的cmp对比结果影响了不同的R0的值,进而R0在内存中取到的值也不同,但是加上R8是永远的固定值r8=0xe02deda1。可以将汇编patch成,根据不同的结果直接跳转
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
.text&ARM.extab:000112DE 00 20 MOVS R0, #0 .text&ARM.extab:000112E0 F4 F7 40 EE BLX time .text&ARM.extab:000112E4 20 44 ADD R0, R4 ; int .text&ARM.extab:000112E6 F4 F7 4A EE BLX srand48 .text&ARM.extab:000112EA F4 F7 4E EE BLX lrand48 .text&ARM.extab:000112EE 59 FB 00 01 SMMLA.W R1, R9, R0, R0 .text&ARM.extab:000112F2 14 2D CMP R5, #0x14 .text&ARM.extab:000112F4 4F EA D1 12 MOV.W R2, R1,LSR#7 ; R1的值逻辑右移7位给R2。.w表示操作是32位的 .text&ARM.extab:000112F8 02 EB D1 71 ADD.W R1, R2, R1,LSR#31 .text&ARM.extab:000112FC C1 EB C1 11 RSB.W R1, R1, R1,LSL#7 ; 将第二个操作数从第一个操作数中减去,R1 = R1 - (R1 << 7) .text&ARM.extab:00011300 A0 EB 41 00 SUB.W R0, R0, R1,LSL#1 .text&ARM.extab:00011304 3C A9 ADD R1, SP, #0xF0 ; 访问栈上的数据,并存入R1寄存器中。 .text&ARM.extab:00011306 00 F1 01 00 ADD.W R0, R0, #1 ; 同样访问栈上的数据 .text&ARM.extab:0001130A 48 55 STRB R0, [R1,R5] .text&ARM.extab:0001130C 30 46 MOV R0, R6 .text&ARM.extab:0001130E 18 BF IT NE ; 条件块,IT就是if then,NE就是 not equal,表示不等于 .text&ARM.extab:00011310 34 30 ADDNE R0, #0x34 ; '4' ; 条件成立就执行 .text&ARM.extab:00011312 00 68 LDR R0, [R0] .text&ARM.extab:00011314 00 D0 BEQ loc_11318 .text&ARM.extab:00011316 E0 E7 B loc_112DA
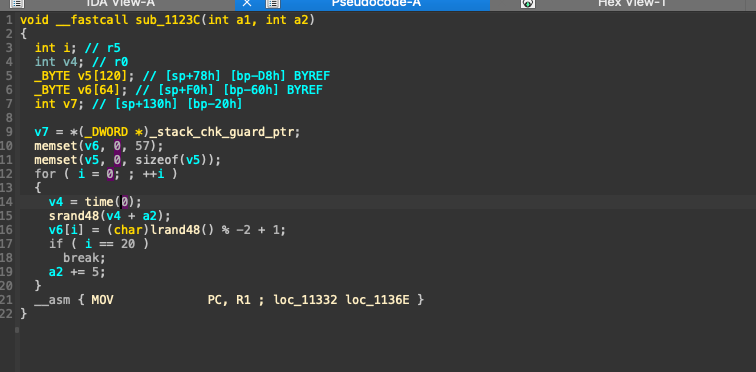
可以看到函数反编译之后和原来不同了,多了一些运行细节。
下一条花指令就到了
1
2
3
4
5
6
7
8
9
10
11
12
13
.text&ARM.extab:00011318 loc_11318 .text&ARM.extab:00011318 63 49 LDR R1, =0x10D0C .text&ARM.extab:0001131A 0C 22 MOVS R2, #0xC .text&ARM.extab:0001131C 00 20 MOVS R0, #0 ;首先给R0赋值0 .text&ARM.extab:0001131E 00 28 CMP R0, #0 ;再进行对比,条件恒为真 .text&ARM.extab:00011320 79 44 ADD R1, PC ; off_22030 .text&ARM.extab:00011322 08 BF IT EQ .text&ARM.extab:00011324 18 22 MOVEQ R2, #0x18 .text&ARM.extab:00011326 0D F1 78 09 ADD.W R9, SP, #0x78 ; 'x' .text&ARM.extab:0001132A 32 AD ADD R5, SP, #0xC8 .text&ARM.extab:0001132C 89 58 LDR R1, [R1,R2] .text&ARM.extab:0001132E 41 44 ADD R1, R8 .text&ARM.extab:00011330 8F 46 MOV PC, R1 ; loc_11332 loc_1136E
这里的条件恒为真,所以一定会跳转到loc_1136E
1
2
3
4
5
6
7
8
9
10
11
12
13
14
.text&ARM.extab:0001136E loc_1136E ; CODE XREF: sub_1123C+F4↑j .text&ARM.extab:0001136E ; sub_1123C+130↑j ... .text&ARM.extab:0001136E 01 21 MOVS R1, #1 .text&ARM.extab:00011370 00 29 CMP R1, #0 .text&ARM.extab:00011372 29 54 STRB R1, [R5,R0] .text&ARM.extab:00011374 4F F0 0C 01 MOV.W R1, #0xC .text&ARM.extab:00011378 08 BF IT EQ .text&ARM.extab:0001137A 18 21 MOVEQ R1, #0x18 .text&ARM.extab:0001137C 51 48 LDR R0, =0x10CAE .text&ARM.extab:0001137E 78 44 ADD R0, PC ; off_22030 .text&ARM.extab:00011380 40 58 LDR R0, [R0,R1] .text&ARM.extab:00011382 00 EB 08 01 ADD.W R1, R0, R8 .text&ARM.extab:00011386 01 20 MOVS R0, #1 .text&ARM.extab:00011388 8F 46 MOV PC, R1 ; loc_11332 loc_1136E
那么这里条件恒为假所以一定会跳转到loc_11332,之后的内容也同样重复操作,最终可以收获一份去掉花指令的反编译的代码。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
void __fastcall sub_1123C (const void *a1, int a2, char *a3, _DWORD *a4) { int v4; int v5; int v6; int v7; int v8; int v9; int v10; size_t v11; char v16; int v17; int v18; int v19; int v20; __int16 v21; _DWORD v22[5 ]; __int16 v23; _DWORD v24[5 ]; __int16 v25; _DWORD v26[5 ]; __int16 v27; _BYTE v28[40 ]; _BYTE v29[40 ]; _BYTE v30[40 ]; _BYTE v31[40 ]; _BYTE v32[24 ]; int v33; v33 = *(_DWORD *)_stack_chk_guard_ptr; memset (v32, 0 , 0x11 u); memset (v31, 0 , sizeof (v31)); memset (v30, 0 , sizeof (v30)); memset (v29, 0 , sizeof (v29)); memset (v28, 0 , sizeof (v28)); v26[0 ] = dword_21600; v26[1 ] = dword_21604; v26[2 ] = dword_21608; v26[3 ] = dword_2160C; v26[4 ] = dword_21610; v27 = (__int16)off_21614; v24[0 ] = dword_21620; v24[1 ] = dword_21624; v24[2 ] = dword_21628; v24[3 ] = dword_2162C; v24[4 ] = dword_21630; v25 = (__int16)off_21634; v22[0 ] = dword_21640; v22[1 ] = dword_21644; v22[2 ] = dword_21648; v22[3 ] = dword_2164C; v22[4 ] = dword_21650; v23 = (__int16)off_21654; v16 = HIBYTE(dword_21660); v17 = dword_21664; v18 = dword_21668; v19 = dword_2166C; v20 = dword_21670; v4 = 0 ; v5 = a2; v21 = (__int16)off_21674; while ( 1 ) { v6 = time(0 ); srand48(v6 + v5); v31[v4] = (char )lrand48() % -2 + 1 ; if ( v4 == 20 ) break ; ++v4; v5 += 5 ; } v7 = 0 ; LABEL_10: v30[v7] = 1 ; v7 = 1 ; while ( 1 ) { v8 = v7 + 1 ; v30[v7] = *((_BYTE *)v26 + v7 + 1 ) ^ *((_BYTE *)v24 + v7 + 2 ); if ( v7 == 15 ) break ; v9 = 12 ; if ( v7 == -1 ) v9 = 24 ; v7 = *(int *)((char *)&off_22030 + v9); if ( !v8 ) goto LABEL_10; } sub_E954(v31, v30, v29); v28[0 ] = v16 ^ LOBYTE(v22[0 ]); v10 = 1 ; do { v28[v10] = *(&v16 + v10) ^ *((_BYTE *)v22 + v10); ++v10; } while ( v10 ); qmemcpy(&v28[15 ], v31, 0x10 u); v11 = (unsigned __int8)(16 - a2 % 16 ); if ( 16 != (unsigned __int8)(a2 % 16 ) ) memset (v32, (unsigned __int8)(16 - a2 % 16 ), (unsigned __int8)(16 - a2 % 16 )); qmemcpy(a3, a1, a2); qmemcpy(&a3[a2], v32, v11); *a4 = v11 + a2; sub_FAD0(a3, a3); qmemcpy(&a3[*a4], v29, 0x10 u); a3[*a4 + 16 ] = 1 ; a3[*a4 + 17 ] = v31[20 ]; *a4 += 18 ; sub_10C8C(a3); }
首先我可以尝试使用frida来hook一下sub_FAD0函数,看看入参内容。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
function hook_sub_FAD0 ( var soname = "libxxx.so" ; var base = Process .getModuleByName (soname).base ; var offset = 0xFAD0 ; var target = base.add (offset).add (1 ) Interceptor .attach (target,{ onEnter :function (args ){ this .tid = this .threadId ; this .inBuf = args[0 ]; this .outBuf = args[1 ]; console .log ('== sub_FAD0 onEnter ==' ); console .log (' inBuf =' , this .inBuf , ' outBuf =' , this .outBuf ); console .log (hexdump (this .inBuf )) }, onLeave :function (retval ){ console .log ("结束" ) console .log (hexdump (this .outBuf )) } }) }
根据执行结果判断,这里的outBuf的内容并不是最终的加密结果。并且sub_FAD0函数也有花指令,需要进行还原。这里存在一个注意的点
1
2
3
4
5
6
7
8
9
10
11
12
.text&ARM.extab:0000FD16 loc_FD16 ; CODE XREF: sub_FAD0+244↑j .text&ARM.extab:0000FD16 42 46 MOV R2, R8 .text&ARM.extab:0000FD18 D0 46 MOV R8, R10 .text&ARM.extab:0000FD1A DF F8 1C A2 LDR.W R10, =(off_21C80 - 0xFD2A) .text&ARM.extab:0000FD1E C4 21 MOVS R1, #0xC4 .text&ARM.extab:0000FD20 98 42 CMP R0, R3 .text&ARM.extab:0000FD22 B8 BF IT LT .text&ARM.extab:0000FD24 44 21 MOVLT R1, #(off_21CC4 - 0x21C80) .text&ARM.extab:0000FD26 FA 44 ADD R10, PC ; off_21C80 .text&ARM.extab:0000FD28 5A F8 01 10 LDR.W R1, [R10,R1] .text&ARM.extab:0000FD2C 29 44 ADD R1, R5 .text&ARM.extab:0000FD2E 8F 46 MOV PC, R1 ; loc_FD30 loc_FEB2
如果我想patch成blt 0xFEB2是不行的,keypatch写出来的内容是32位的指令,所以我只能修改成反过来的形式。
最后我们修复完所有的花指令后找到sub_FAD0,但是这里其实还有ollvm混淆,暂时不想解了。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 void __fastcall sub_FAD0 (_BYTE *a1, _BYTE *a2, unsigned int a3, int a4, int a5) { int v7; int v8; int i; int v10; int v13; unsigned int v14; _BYTE *v15; _BYTE *v16; _BYTE *v17; char v18; _BYTE *v19; _BYTE *v20; _BYTE *v21; unsigned int v22; _BYTE v23[176 ]; int v24; v24 = *(_DWORD *)_stack_chk_guard_ptr; v18 = a3 & 0xF ; memset (v23, 0 , sizeof (v23)); *a1 = *a2; v7 = 1 ; do { a1[v7] = a2[v7]; ++v7; } while ( v7 ); v8 = -1114759073 ; if ( !a5 ) v8 = -415789667 ; v13 = v8; for ( i = 1789162905 ; ; i = -75914478 ) { while ( 1 ) { while ( i >= -75914478 ) { if ( i < 635143994 ) { if ( i >= 551524902 ) i = v13; } else if ( i < 1108444786 ) { i = 551524902 ; if ( !v18 ) i = -1101893120 ; } else if ( i >= 1789162905 ) { v22 = v14; v20 = v16; v19 = v17; v21 = v15; i = 635143994 ; if ( v14 < a3 ) i = -1724549538 ; } } if ( i >= -1101893120 ) break ; if ( i >= -1114759073 ) { sub_FF84(v21, v20); *v19 = *v21; v10 = 1 ; do { v19[v10] = v21[v10]; ++v10; } while ( v10 ); sub_EAC0(v19, v23); v15 = v21 + 16 ; v17 = v19 + 16 ; v16 = v19; v14 = v22 + 16 ; i = 1108444786 ; } } if ( i < -1078469004 ) break ; sub_E9E8(v23, a4); } }
根据MCP的分析,这里是AES-128 CBC 分组加密/解密例程。a1:输出缓冲,a2输入缓冲,a3总长度,a4密钥指针(传入16字节key),a5模式标志(1=加密,0=解密,来控制分叉)。
关键迹象
v23 为 176 字节的本地缓冲:这正是 AES-128 轮密钥长度(11×16)。
sub_E9E8(v23, a4): 生成轮密钥(key schedule)。
sub_EAC0(v19, v23): 对 16 字节块做 AES 核心变换(加/解密)。
sub_FF84(v21, v20): 与上一块/IV 做异或,典型 CBC 链接操作。
循环每次处理 16 字节:更新 v15/v16/v17 指针并把偏移 v14 += 16,直到 v14 >= a3。
那么经过我的hook发现,sub_FAD0是进行加密,加密的密文是
1
2
3
4
5
6
7
8
9
0 1 2 3 4 5 6 7 8 9 A B C D E F 0123456789ABCDEF 9a72d490 fc df 30 7d ed 70 49 ca d6 30 5b 3b d0 89 60 04 ..0}.pI..0[;..`. 9a72d4a0 bd 36 f9 c1 b8 ff 4e 78 86 6c 2b 49 a0 40 93 84 .6....Nx.l+I.@.. 9a72d4b0 32 a0 2b 81 11 c0 b8 32 7a 0c 79 d9 3e 12 8c 0a 2.+....2z.y.>... 9a72d4c0 7b 08 c1 86 5e c5 5a 09 9c 62 91 c0 96 cc 8e 3d {...^.Z..b.....= 9a72d4d0 55 da f2 45 05 7a bb 39 09 ce e6 ee de 39 78 38 U..E.z.9.....9x8 9a72d4e0 12 79 8d fc d4 71 2b 3f 96 11 a2 10 e5 23 6e 15 .y...q+?.....#n. 9a72d4f0 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 ................ 9a72d500 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 ................
之后sub_10C8C函数进入之前,这块内存的内容尾部被追加了18个字节的数据
1
2
3
4
5
6
7
8
9a72d490 fc df 30 7d ed 70 49 ca d6 30 5b 3b d0 89 60 04 ..0}.pI..0[;..`. 9a72d4a0 bd 36 f9 c1 b8 ff 4e 78 86 6c 2b 49 a0 40 93 84 .6....Nx.l+I.@.. 9a72d4b0 32 a0 2b 81 11 c0 b8 32 7a 0c 79 d9 3e 12 8c 0a 2.+....2z.y.>... 9a72d4c0 7b 08 c1 86 5e c5 5a 09 9c 62 91 c0 96 cc 8e 3d {...^.Z..b.....= 9a72d4d0 55 da f2 45 05 7a bb 39 09 ce e6 ee de 39 78 38 U..E.z.9.....9x8 9a72d4e0 12 79 8d fc d4 71 2b 3f 96 11 a2 10 e5 23 6e 15 .y...q+?.....#n. 9a72d4f0 bd bf 1a 63 5f b5 0a ae 6a 69 14 ab 10 d6 2f a6 ...c_...ji..../. 9a72d500 01 29 00 00 00 00 00 00 00 00 00 00 00 00 00 00 .)..............
最后执行完sub_10C8C函数之后这里的位置就变成了真正最后加密完成的数据,可以使用unidbg解密回原始数据的那种
1
2
3
4
5
6
7
8
9a72d490 96 7f fa 63 d2 8b 23 6a 1c 2e 64 c0 08 ab a2 2f ...c..#j..d..../ 9a72d4a0 2a c0 a2 be 7a bb 0b 7e ec cc e1 57 9f bb 4b a6 *...z..~...W..K. 9a72d4b0 f0 8b bc 77 4a bf 7a 76 3f 0a 13 79 f4 0c b3 f1 ...wJ.zv?..y.... 9a72d4c0 a3 2a 03 ad c9 33 01 76 5e 26 d4 c6 fc 6c 44 23 .*...3.v^&...lD# 9a72d4d0 6a 21 2a 67 c7 51 2c cf 52 b1 24 aa 9b 3f 12 98 j!*g.Q,.R.$..?.. 9a72d4e0 d8 67 b2 07 0c 53 e9 14 01 e7 f9 6f 27 67 2b 13 .g...S.....o'g+. 9a72d4f0 d7 1f d0 7d 60 4e d2 8c a8 42 83 5d 4b a9 ed e2 ...}`N...B.]K... 9a72d500 44 2f 00 00 00 00 00 00 00 00 00 00 00 00 00 00 D/..............
所以现在首先来探究追加的18个字节的数据的来源是什么,根据GPT的分析,来源由三部分组成
16 字节 v29: 由 sub_E954(v31, v30, v29) 计算得到的派生块(v30 来自常量表,v31 是长度为 21 的序列)。
1 字节常量:0x01
1 字节标志:v31[20]
v31由time(0)+seed重播种的lrand48()逐轮生成,v31[20]是其最后一个元素。
针对sub_E954的花指令修复完毕之后,是其内容
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
void __fastcall sub_E954 (_BYTE *a1, int a2, _BYTE *a3) { int v6; _BYTE v7[180 ]; int v8; v8 = *(_DWORD *)_stack_chk_guard_ptr; memset (v7, 0 , 0xB0 u); *a3 = *a1; v6 = 1 ; do { a3[v6] = a1[v6]; ++v6; } while ( v6 ); sub_E9E8((int )v7, a2); sub_EAC0(a3, v7); }
使用frida来hook这个函数看看其输入输出,判断
a1: 16 字节输入块(这里即 v31[0..15])
a2: 16 字节密钥(这里即从常量表派生的 v30 的前 16 字节)
a3: 16 字节输出块(这里即 v29)
先把 a1 拷到 a3 → sub_E9E8 用 a2 生成 176 字节轮密钥 → sub_EAC0 用该轮密钥对 a3 做单块加密,v29 = AES-128-ECB_Encrypt( v31[0..15], key=v30[0..15] )
1
2
3
4
5
6
7
8
9
10
11
12
13
14
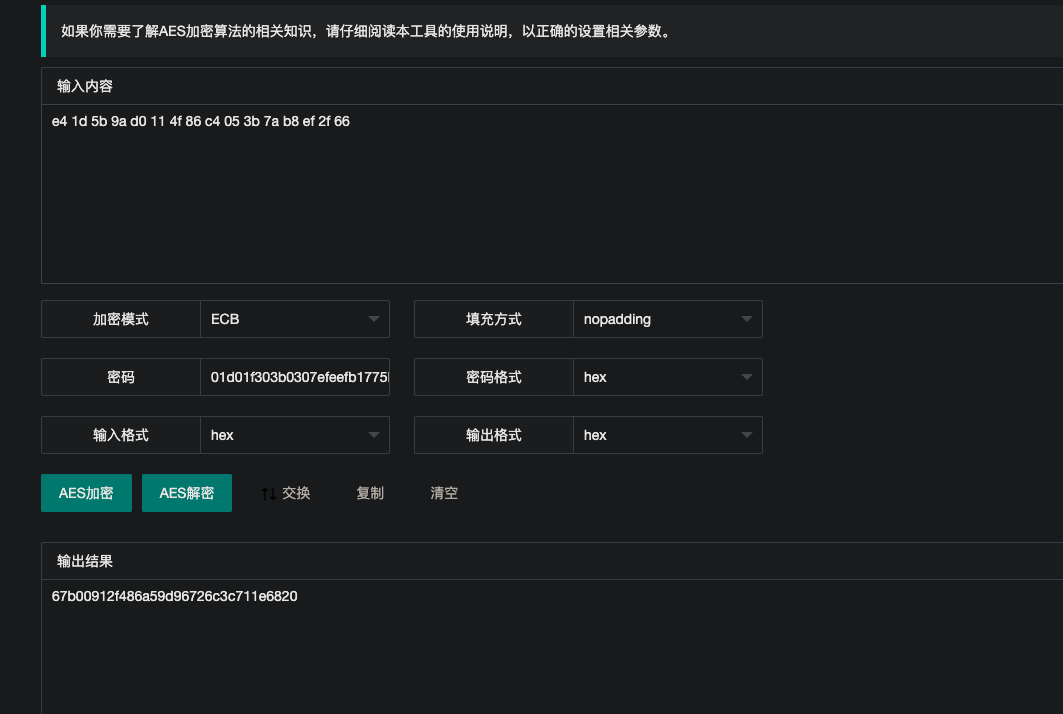
== sub_E954 onEnter == in (16): 0 1 2 3 4 5 6 7 8 9 A B C D E F 0123456789ABCDEF 9693b060 e4 1d 5b 9a d0 11 4f 86 c4 05 3b 7a b8 ef 2f 66 ..[...O...;z../f key(16): 0 1 2 3 4 5 6 7 8 9 A B C D E F 0123456789ABCDEF 9693b038 01 d0 1f 30 3b 03 07 ef ee fb 17 75 b8 28 eb 30 ...0;......u.(.0 out pre: 0 1 2 3 4 5 6 7 8 9 A B C D E F 0123456789ABCDEF 9693b010 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 ................ == sub_E954 onLeave == out(16): 0 1 2 3 4 5 6 7 8 9 A B C D E F 0123456789ABCDEF 9693b010 67 b0 09 12 f4 86 a5 9d 96 72 6c 3c 71 1e 68 20 g........rl<q.h
验证下来就是AES的ECB nopadding模式的加密,获取到加密结果,正是输出的结果。
那么分析完了这个内容,就要分析最后一步也就是sub_10C8C函数了,根据unidbg的给的trace内容可以发现其实就是xor处理
1 2 3 4 5 6 7 8 9 before = bytes .fromhex("fcdf307ded7049cad6305b3bd0896004bd36f9c1b8ff4e78866c2b49a040938432a02b8111c0b8327a0c79d93e128c0a7b08c1865ec55a099c6291c096cc8e3d55daf245057abb3909cee6eede39783812798dfcd4712b3f9611a210e5236e15bdbf1a635fb50aae6a6914ab10d62fa60129" ) after = bytes .fromhex("967ffa63d28b236a1c2e64c008aba22f2ac0a2be7abb0b7eeccce1579fbb4ba6f08bbc774abf7a763f0a1379f40cb3f1a32a03adc93301765e26d4c6fc6c44236a212a67c7512ccf52b124aa9b3f1298d867b2070c53e91401e7f96f27672b13d71fd07d604ed28ca842835d4ba9ede2442f" ) ks = bytes (a ^ b for a, b in zip (after, before)) print ("keystream:" , ks.hex ())
直接把key给跑出来,可以看到这个key是一个循环的,基础块是6aa0ca1e3ffbd822c22b97f65b7fc2444506,根据输入的长度不断的进行拼接,最后如果长度不够了,就截取一部分放到生成的key的最开头。所以这里可以直接写脚本。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
def xor_bytes (a: bytes , b: bytes ) -> bytes : return bytes (x ^ y for x, y in zip (a, b)) def generate_keystream (base_key: bytes , length: int ) -> bytes : """ 根据基础密钥块生成指定长度的密钥流 如果最后一次循环超出输入长度,则将截取的部分拼接到开头 base_key: 基础密钥块 length: 需要的密钥流长度 """ key_length = len (base_key) full_cycles = length // key_length remainder = length % key_length if remainder == 0 : return base_key * full_cycles else : remainder_part = base_key[:remainder] full_part = base_key * full_cycles return remainder_part + full_part base_key = bytes .fromhex("6aa0ca1e3ffbd822c22b97f65b7fc2444506" ) final = bytes .fromhex("1b77cf9de25c7577c797cc5556c9e56e61d07153ed5ab7ae188b913a1a4b3c79a7dc95dbf4d4433212dff613f8fbe9d426ca1a3c542548a3755e0390b3c9edea5f2384fe893c5d759a20cb5b1e30399c4896a5e6207c3137f14224ffc89dcf6d014b" ) ks = generate_keystream(base_key, len (final)) pre10c8c = xor_bytes(final, ks) print ("还原后的数据:" , pre10c8c.hex ())
0x03 算法分析 很好我们现在已经完整的分析出来了加密的逻辑,进入到sub_B458函数之后,处理了Java层输入的内容之后就进去到了,sub_11BE8函数内部会直接进入sub_1123C,该函数中有三步处理
sub_E954函数是对原始的加密的AESkey进行加密的,生成的是最后拼接在密文后的16字节数据,使用的是AES-ECB模式,加密解密的key是01d01f303b0307efeefb1775b828eb30固定值
sub_FAD0函数就是AES-CBC的加密函数,对用户输入的数据进行加密,加密的key是sub_E954函数进行加密之前的值,加密的iv是一个前15字节固定,最后一个字节随机的值14 3e 37 23 0d ed d5 44 72 0b 76 0e 50 02 c9 xx,那么最后一位的这个iv的随机值,就是key的第一个字节的内容,比如key的第一位是16 ,那么iv的最后一位就是16。
sub_10C8C函数就是一个xor函数,其基础块是6aa0ca1e3ffbd822c22b97f65b7fc2444506,根据用户的输入长度进行循环,如果最后一次拼接超出了用户输入的长度,那么就切割基本块到一致长度之后拼接到密钥的开头。
所以最终拿到加密数据的时候,首先解码base64之后,先进行xor的运算,还原明文,之后去掉最后两字节的数据,并取出最后16字节的数据,进行AES-ECB模式的解密,获取到解密的AES-CBC的key,将第一字节的数据拼接到IV上,获取到IV,就可以进行数据的解密了。